背景
26年以来,vibecoding已经逐渐成为程序员的主流工作方式,绝大多数程序员的工作都是借助ai完成,而ai编程消耗token巨大,直接走Pay as you go的官方价格太贵,coding plan或者叫订阅就成了很多人的选择。
官价
在开始对比订阅之前,我们先来说一下模型的官方价格,文章采用三个数字来表示价格缓存/输入/输出的价格,开源模型除了官方还有一些供应商自部署价格可能与官方不同,这里我们还是以官方价格为准,用一个实际价格=80%缓存命中率来进行整体估算。
flash级别模型的官方价格如下,大多数都在1米都2米的范围内,目前以下模型的日均用量都非常大,是目前编程token量的主力。
| 模型名称 | 缓存/输入/输出 | 估算 |
|---|---|---|
| mimo-v2.5 | 0.0028/0.14/0.28 | 1米(0.03) |
| deepseek-4.1-flash | 0.003/0.15/0.6 | 1米多点(0.032) |
| hy3 | 0.02/0.08/0.33 | 1米多点(0.032) |
| glm-5.3-flash | 0.03/0.15/0.5 | 1米多(0.054) |
| gpt-5.6-luna | 0.02/0.2/1.2 | 1米多(0.056) |
| gemini-3.8-flash | 0.075/0.75/3.75 | 7米(0.21) |
期间级别的模型在开源和闭源模型上差异巨大,如下,
| 模型名称 | 缓存/输入/输出 | 估算 |
|---|---|---|
| glm-5.3 | 0.26/1.4/4.4 | 16米(0.49) |
| claude-sonnet-5 | 0.2/2/10 | 18米(0.56) |
| gpt-5.6-terra | 0.2/2/12 | 18米(0.56) |
| qwen-3.8-max | 0.25/2/6 | 20米(0.6) |
| claude-opus-5 | 0.5/5/25 | 20米(0.6) |
| grok-4.6 | 0.5/2/6 | 27米(0.8) |
| kimi-k3 | 0.3/3/15 | 28米(0.84) |
| gpt-5.6-sol | 0.4/4/20 | 37米(1.12) |
| claude-fable-5.1 | 0.25/10/50 | 73米(2.2) |
| gpt-6-astra | 1/10/50 | 92米(2.8) |
小结:在极致性价比上,国产开源模型依然优势很大,尤其是小米、deepseek、智普等flash模型,而旗舰模型上,国内一般就是一个pro档位,flash/pro两个档位。但是OA两家则是分了4个级别,低(luna)中(terra)高(sol)还有最高(astra),目前国模的pro在大众体感上应该是介于terra和sol之间的能力,这和定价也基本能相匹配,所以旗舰模型上,国模性价比目前并不算高。尤其是kimi-k3已经非常贵了。
订阅
openai
| OpenAI套餐 | 价格 | 等价token钱 | 倍率 |
|---|---|---|---|
| plus | 20 | 300~600 | 15~30 |
| pro x5 | 100 | 900~2000 | 9~20 |
| pro x20 | 200 | ~10000(样本差异较大) | 50 |
数据来源:
- openai plus
- reddit 用户一个周的等效额度大概是100刀,一个月400+
- 我个人有plus订阅,绝大部分请求都经过codex-proxy,这个软件里面记录了周额度使用了63%,实际等效的价格显示$65,推测一个月等效额度趋势是100刀多一点,一个月400+可信度较高
- openai pro x5
- reddit 推算出周额度是307,月1335刀。
- openai pro x20
小结:
订阅机制是一种补贴机制,大量的低使用度用户补贴高使用度的用户,最终摊薄,对于程序员来说,用到80%甚至100%的额度是比较常见的,所以折算下来价格非常合适,所以我每次也非常开心codex用户量的增长,尤其是普通办公人员来订阅codex,这意味着他们这些低用度人群又可以来补贴程序员了。当然订阅的官方并不承诺一定给多少的额度,是一个动态的有最终解释权的补贴方案,但以目前的形式大概plus和prox5的倍率可以按照20倍估算,而x20则是50倍,
但是也能看出,其实x5虽然价格x5了,实际额度上似乎并没有到x5,大概是x2.+。而x20价格上其实是x10,额度上应该是没有到x20,但是是大于x10+的,所以性价比最高的是x20,其次是plus,然后是pro x5。目前openai下架了x20套餐,你大概知道为啥了吧,因为x20不复存在,所以我们统一给openai的订阅一个20的倍率数。重新看他的几个模型价格。
| 模型名称 | 原价 | 订阅 |
|---|---|---|
| gpt-5.6-luna | 1米多(0.056) | 不到0.1米 |
| gpt-5.6-terra | 18米(0.56) | 0.9米 |
| gpt-5.6-sol | 37米(1.12) | 1.9米 |
| gpt-6-astra | 92米(2.8) | 4.6米 |
anthropic
| OpenAI套餐 | 价格 | 等价token钱 | 倍率 |
|---|---|---|---|
| pro | 20 | 650~1300 | 32~65 |
| max x5 | 100 | 2000~3500 | 20~35 |
| max x20 | 200 | 4000~13000(同样样本差距大) | 20~65 |
数据来源:
- pro
- reddit 原贴已删,用户生成月折合1200刀。
- max x5 x20
小结:
一样的价位,甚至比openai更高的倍率,整体我们可以按照30倍率的档位来计算的,但是大部分数据测试是隔得月数有点多了,近期有额度下降的说法,我们保守一点给个25的倍率。
| 模型名称 | 原价 | 订阅 |
|---|---|---|
| claude-sonnet-5 | 18米(0.56) | 0.7米 |
| claude-opus-5 | 20米(0.6) | 0.8米 |
| claude-fable-5.1 | 73米(2.2) | 2.9米 |
opencode go
价格10刀(最早有首月5刀,现在没了),实际用量上限是60刀,部分模型换算的额度则更少,比如luna模型只能用15刀,kimi-k3也是只有15刀,glm-5.3-flash是60刀。总结下来就是10刀最多能换60刀,也就是6倍的倍率,部分模型是1.5倍的倍率,比较低,6倍一般是老模型或flash。
| 模型名称 | 原价 | 订阅 |
|---|---|---|
| mimo-v2.5 | 1米(0.03) | 0.17米 |
| deepseek-4.1-flash | 1米多点(0.032) | 0.17米 |
| glm-5.3-flash | 1米多(0.054) | 0.3米 |
| gpt-5.6-luna | 1米多(0.056) | 1.24米 |
小结:
可选的模型很多,但是没有OA家族旗舰,只有个luna,如果想用多个开源国模的话,他是比管价低的,但是渠道上没能谈到像oa那样自家摊薄成本的低价,我觉得也可以理解,opencode go订阅的都是编程人员啊,比如他跟glm谈了个flash模型能打5折的商单,就已经很不错了,然后5折基础上,他自己再做订阅,又有摊薄成本,大部分用户用不完,每个人平均用不到一半的话,所以最后就有了6x的倍率也就是2折左右的价格。
比较无奈的是opencode的用户都是程序员,用量不小,肯定比openai这种面向全职业的人均用量大,所以很难把价格压低,可以理解,表示尊重,但是之前的首月优惠用完,就没再订阅了。
command code goat
command goat套餐是对opencode go的精准打击,也是10刀的价格,但是月度用量上限是70,比opencode go的60多一点,然后支持的模型包括了go中没有的高端模型gpt-sol并且全都拿来用sol的话额度就是70,luna则是20,所以luna的倍率反而比较低,但是也有20刀了,go的luna只有15刀。
| 模型名称 | 原价 | 订阅 |
|---|---|---|
| mimo-v2.5 | 1米(0.03) | 0.3米 |
| deepseek-4.1-flash | 1米多点(0.032) | 0.17米 |
| glm-5.3-flash | 1米多(0.054) | 0.45米 |
| gpt-5.6-luna | 1米多(0.056) | 0.93米 |
| gpt-5.6-sol | 37米(1.12) | 5.3米 |
小结:
整体就是精准打击go的,更多的额度,且支持sol模型,且sol折算下来价格只有5米了,已经是正规渠道里第二低的sol价格了,但是相比openai订阅的1.9米还是贵了不少,由此可见oa两家官方订阅的性价比是高出天际的,为啥command/go这些都做不到官方的订阅的倍率呢?首先就是人家自己模型自己的机房自己能控制,且没有标注就是20刀换500刀的,动态的,自己根据各种机器成本、运营、宣传等等算下来的真实成本,最终给用户的一个量,所以go这些去跟oa谈的时候,肯定是拿不到这个价格的,甚至2倍都拿不到,从结果来看5米比2米多了2.5倍,但商单谈的价格应该是更高的,因为command本身也套了一层订阅摊薄,即使这样还只能做到5米,说明实际谈的价格更高。
话说回来command goat是比go更具有性价比的订阅套餐了,如果你是开源模型为主力,并且偶尔有复杂任务想用sol的话,非常合适。不过10刀换的70刀额度不算多,我个人非工作在家使用,进行一些小项目的开发维护,大概在每个月500-1000刀的等效额度(不算在公司的工作使用),使用gpt-5.6-sol,思考强度为low,作为参考同样的用量的话,mimo-v25大概需要20刀就够了,所以command goat和opencode go的套餐以国模和flash模型为主力的话,对个人来说是够用的,但如果你要用sol作为主力,70刀恐怕很难撑过1周。
哦,对了,另外一个要注意的是command的gpt模型不支持responses协议,你需要有一个转换器,像ccswitch或者nanollm之类的才能在codex中使用。
中转站
如果你想要用OA两家的高端模型,又想要20x的倍率,极低的价格,那么首选就是订阅,但是订阅需要你自己有梯子,国内无法购买、无法访问,即使有了梯子,也有概率被封号,尤其是A/,对中国人不太友好,话说回来,在公司也停掉claude模型,并不建议用cc后,我已经没再用过claude模型了,fable5.1到现在我都没体验过。Anyway,openai的风控相对松一点,还可以通过经典的美区id+苹果礼品卡的方式购买,但是也有风险。那最后的方案就是中转站了,让中间商赚点插件,但是能享受到接近订阅的价格,听上去也是三赢的,你获得接近订阅套餐的价格,中间商赚了差价,奥特曼刷了业绩。
我们先来说中转站的分类,其实中转这一行,又分为号商(专门卖成品号的,不算中转大部分用户不知道)、一手中转(订阅pro号的号池直接提供服务)、n手中转(套娃的)、混合中转(自己有号池,也有套娃,也有逆向等渠道,到模型详情会发现一个模型有数个分组,而且分组经常过几天就变了)。
一手
这里最建议的是一手中转,大部分是只做gpt模型或者偶尔搞点其他的,但是服务gpt模型为主的,因为claude封号太猛,中转干不下去。一手中转只有2层中间商差价(号贩子和他自己)所以价格相对核算,比如我也在用一个中转站上个月大概就是25的倍率,1元换25元的用量。他用的是prox20账号的号池,prox20压榨之后应该能到40+的倍率的,所以他是不亏的。这个月因为20x取消了,他们把价格涨了将近50%,现在倍率不到20了,也在等待看20x啥时候能恢复。有人会问20x没了,用10x不行吗,可以看上面的统计结果,10x的倍率还是比较低的性价比很差,甚至可能不如plus的性价比高,属于一个鸡肋的档位。
标准
这里也是一种判断标准,你到中转发现价格是能有20+倍的倍率才是比较合算的,有些平台只有7-10倍的,这种就是不知道套了多少层了,基本就不用考虑了,还有逆向渠道的基本也不要考虑,逆向非常不稳定,订阅号池的才是更稳定的(最最稳定的肯定还是自己订阅)。那种一个中转站里面支持上百种模型的,基本就不可能是一手,这种都是套了不知道多少层的,不同的模型又有不同的渠道,每个渠道本身也不一定稳定,他一个渠道挂了,你编程就停了,你去看群里发现是xxx下线了,然后你去换什么分组 key 或者模型,实在是浪费时间,所以不建议这种大而全的站。
缓存
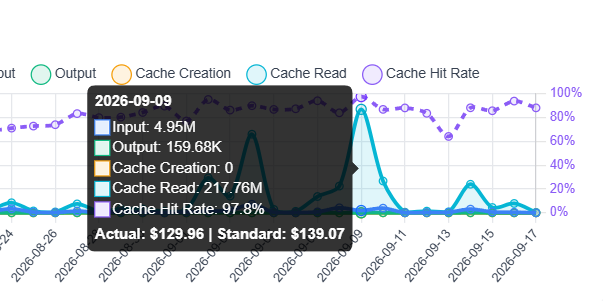
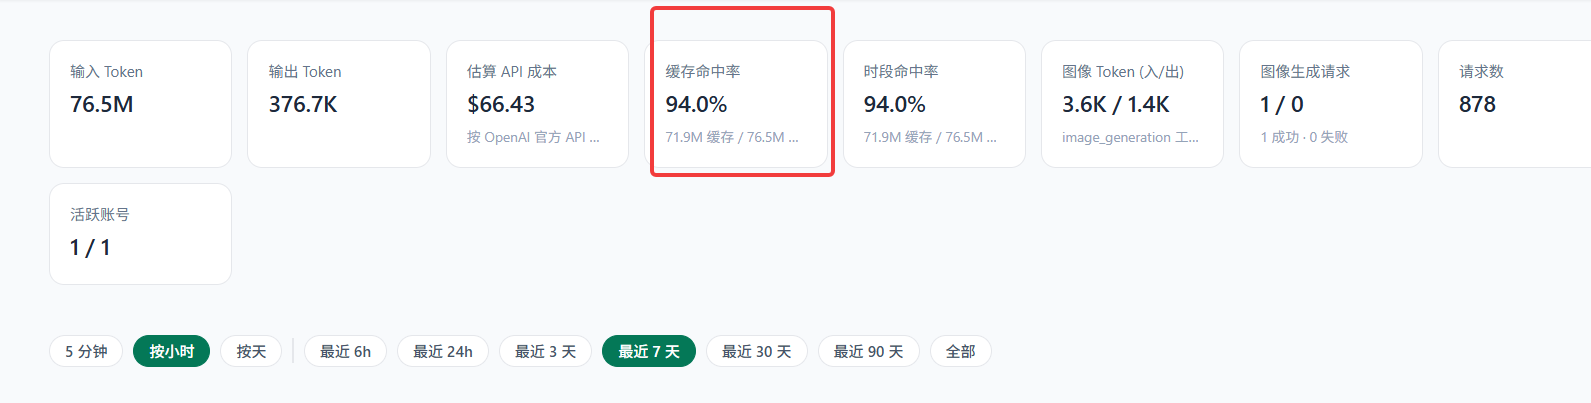
中转的缓存容易被搞手脚,一定要多观察缓存命中率的指标要在至少85%以上,如果你购买了官方订阅并且在codex中使用的话,会发现用下来缓存命中率一直在95%左右的样子,这是因为官方对每个账号的缓存是分开的。但是中转做不到,中转是同一个账号服务好多个用户,只能尽量把同一个用户路由到同一个账号上,但是仍然会有账号窗口透支了,或者坏掉了,或者负载高,切换到其他账号的情况,但是整体波动不会太大,所以缓存命中率不说95%,85%也是一个正常的区间,尤其是连续使用,长对话的时候,如下是中转的,相对来说缓存命中率不太稳定,高强度时候尚可,轻度使用会跌到80%左右。
然后下图是我的plus订阅的统计数据,7天的总的命中率94%
小结:
中转站良莠不齐,pro号池的一手站相对稳定,价格也可以接受,基本是享受到了plus的性价比,而且没有5小时窗口限制,如果不是特别关注自己的代码数据的话,是一个不错的选择。但是能订阅还是订阅吧,我现在是gpt plus订阅,但是会撞5h的限额,所以配合了有一点余额的中转,然后在railway上部署的nanollm,优先路由到plus订阅,限额之后会路由到中转站,这样不用vpn,不用非得codex,还不用自己手动切换。
国内coding plan
国内主流的供应商也有coding plan,整体性价比比OA都要低,但是也拿来说一下,我让AI帮我总结了一份,90命中率左右下等效价格
| 套餐 | 月费 | 估计月 Raw Token | API 等效价值/月 | 价值/月费 |
|---|---|---|---|---|
| GLM Lite | ¥118 | 约1.87–3.74亿 | 约 ¥520–1,035 | 4.4–8.8倍 |
| GLM Pro | ¥538 | 约11.4–22.9亿 | 约 ¥3,165–6,330 | 5.9–11.8倍 |
| GLM Max | ¥1,078 | 约26.7–53.3亿 | 约 ¥7,380–14,750 | 6.8–13.7倍 |
| Kimi ¥199 | ¥199 | 约12–15.7亿 | 约 ¥2,400–3,140 | 12.1–15.8倍 |
| MiniMax Plus | ¥49 | 6亿 | 约 ¥373 | 7.6倍 |
| MiniMax Max | ¥119 | 18亿 | 约 ¥1,118 | 9.4倍 |
| MiniMax Ultra | ¥469 | 55–71亿 | 约 ¥3,415–4,410 | 7.3–9.4倍 |
| 阿里 Lite | ¥39 | Credits,无固定 Token | 可靠下限约 ¥54 | 至少约 1.4倍 |
| 阿里 Standard | ¥139 | Credits,无固定 Token | 可靠下限约 ¥218 | 至少约 1.6倍 |
| 阿里 Pro | ¥499 | Credits,无固定 Token | 可靠下限约 ¥870 | 至少约 1.7倍 |
可以看到倍率大都在10以内,和command goat差不多,可能比command的性价比高一点,但是高不了多少,而command还能用多家模型,这里基本只能用本家。和OA两家比倍率更是差了1倍以上。
为什么
为什么OA家的倍率20以上,国模到10都很难呢?我觉得主要是闭源模型的定价虚高,成本其实没有那么高,定价也是一门学问。而国模都是开源的,大家都是知道部署之后的成本价格的,所以官价的溢价已经不高了。
反直觉
其实opus和sol(1-2米)的订阅后的价格比glm5.3(2-4米)还要便宜,这也是为什么中转站不太可能用国模掺水的原因,国模比OA家的要贵的。具体为什么国模这么贵呢?代码能力好像还不如OA,价格为啥还要贵一点呢,我觉得一方面是高端显卡资源卡脖子,另一方面跑模型的成本取决于模型的大小,并不取决于他的能力强弱,我记得以前古剑奇谭用当时最好的显卡都卡,并非游戏画面有多好。
小米呢
为啥上面没有小米的订阅,因为小米采用了另外的计价方案,他其实本质上和deepseek差不多,就是官方定价已经没有什么溢价了,并且用量较大尤其是flash模型长期霸榜openrouter,本身没有什么压榨空间了,订阅用户里很难劫富济贫,全是丐帮的兄弟,所以虽然有coding plan,但是小米的倍率非常低只有1.x,相当于是一种预付费可以打9折之类的优惠。
小结:
国产coding plan如果依赖国产模型为主的话,是可以考虑的,可以和opencode go进行对比,让ai细致对比后,你会有一个答案,另外一般官方一手的缓存命中率会比go goat这些二道贩子要高的,所以实际用量上,官方套会更耐用一点。
最后
最后说点商业模式。
在公开权重之后,你会看到在openrouter上有些provider的定价比官方还便宜。开放权重后,第三方可以自行选择:
- 更便宜的 GPU 集群
- 国产 GPU 或特定推理芯片
- FP8、INT8、INT4 量化
- 更大的动态批处理
- 更高的 GPU 利用率
- 更便宜的夜间算力
- 更激进的 KV Cache 管理
- 较低的服务利润率
- 用其他业务补贴推理服务
等等方式压到比官方还低的价格,但是实际的模型表现已经跟官方不同了,他们处理相同任务的能力表现可能因为量化或者上下文大小不同而不同,实际的价格也可能因为缓存方案不同,基础价格低,但是缓存命中率不高,导致最后价格比官方还高。但是更低的明码标价赚足了噱头,吸引了客户。
另外大模型公司像kimi glm包括openai等,他们主要客户还是tob市场,而tob的公司购买的不仅是模型本身的能力,他们并不会为了便宜30%就购买一个第三方的供应商,而是一个打包的服务,稳定性,sla,责任边界,技术支持,模型长期维护等等,这些都是比模型调用本身更重要的。因此开放模型的商业模式通常不是“卖模型文件”,而是:卖托管、部署、集成、稳定性、合规和持续服务。
那为什么还要做低价 Coding Plan?
Coding Plan 不一定直接以利润最大化为目标,它通常还有几个战略作用。
- 抢占开发者入口(开发者都在用qoder,那公司是不是更多的考虑阿里的商单)
- 培养使用习惯(用户习惯了gpt的回复语气,一样的能力用不惯glm罗里吧嗦)
- 获取真实任务反馈(c端的又穷又爱吐槽,获得反馈可以更好的优化后续模型)
- 消化闲置算力(显卡放着也要供电,晚上便宜点也比没人用能回本)