1 model.json
codex中有一份可以被覆盖的模型元数据配置model.json文件,他直接决定了,发起的llm请求的格式。在源码的这个地方。
我们拿出第一个也就是gpt-6-astra为例,可以看到这里面有很多基础的元数据配置,其中slug是请求中的模型名,display_name是展示在app中的名字。supported_reasoning_levels是支持的思考强度列表,context_window是当前模型的上下文窗口大小,max_context_window是最大的上下文窗口大小,input_modalities是支持的多模态这里是图文两种,以上就是一些基础的容易理解的配置。
{
"slug": "gpt-6-astra",
"prefer_websockets": true,
"support_verbosity": true,
"default_verbosity": "low",
"apply_patch_tool_type": "freeform",
"web_search_tool_type": "text_and_image",
"input_modalities": [
"text",
"image"
],
"supports_image_detail_original": true,
"truncation_policy": {
"mode": "tokens",
"limit": 10000
},
"supports_parallel_tool_calls": true,
"tool_mode": "code_mode_only",
"multi_agent_version": "v2",
"multi_agent_reasoning_effort": "xhigh",
"use_responses_lite": true,
"supports_reasoning_effort_updates": true,
"include_skills_usage_instructions": false,
"include_apps_usage_instructions": false,
"include_plugin_usage_instructions": false,
"guardian": null,
"node_repl_auto_review_required": true,
"node_repl_disabled": false,
"requires_sandboxed_review": false,
"auto_review_model_override": null,
"model_specialty": null,
"context_window": 272000,
"max_context_window": 872000,
"auto_compact_token_limit": null,
"comp_hash": "3000",
"default_reasoning_summary": "none",
"display_name": "GPT-6-Astra",
"description": "Frontier intelligence for the most demanding work.",
"default_reasoning_level": "low",
"supported_reasoning_levels": [
{
"effort": "low",
"description": "Fast responses with lighter reasoning"
},
{
"effort": "medium",
"description": "Balances speed and reasoning depth for everyday tasks"
},
{
"effort": "high",
"description": "Greater reasoning depth for complex problems"
},
{
"effort": "xhigh",
"description": "Extra high reasoning depth for complex problems"
},
{
"effort": "max",
"description": "Maximum reasoning depth for the hardest problems"
},
{
"effort": "ultra",
"description": "Maximum reasoning with automatic task delegation"
}
],
"shell_type": "shell_command",
"visibility": "list",
"minimal_client_version": "0.153.0",
"supported_in_api": true,
"availability_nux": null,
"upgrade": null,
"priority": 1,
"model_messages": {
// 省略
},
"experimental_supported_tools": [
"send_user_message_async",
"clock"
],
"available_in_plans": [
// 省略
],
"supports_search_tool": true,
"supports_experimental_context": false,
"default_service_tier": null,
"service_tiers": [
{
"id": "priority",
"name": "Fast",
"description": "2x speed, increased usage"
}
],
"additional_speed_tiers": [
"fast"
],
"supports_reasoning_summary_parameter": true,
"supports_reasoning_summaries": true
}
2 use_responses_lite
是否采用lite模式的请求格式,lite请求格式主要是将两个字段从根字段移动到了input数组中,一个是tools会从$.tools移动到input的第一个元素,type=additional_tools。另一个则是instructions系统提示词,从$.instructions移动到input的第二个元素,type=message, role=developer。
从官方配置看,gpt5.5还是非lite,5.6之后都已经采用lite模式了,而这个字段默认值是false,也就是如果你配置非gpt模型的话,建议是用非lite,主要是input.type=additional_tools这个类型,在很多供应商是不支持的。
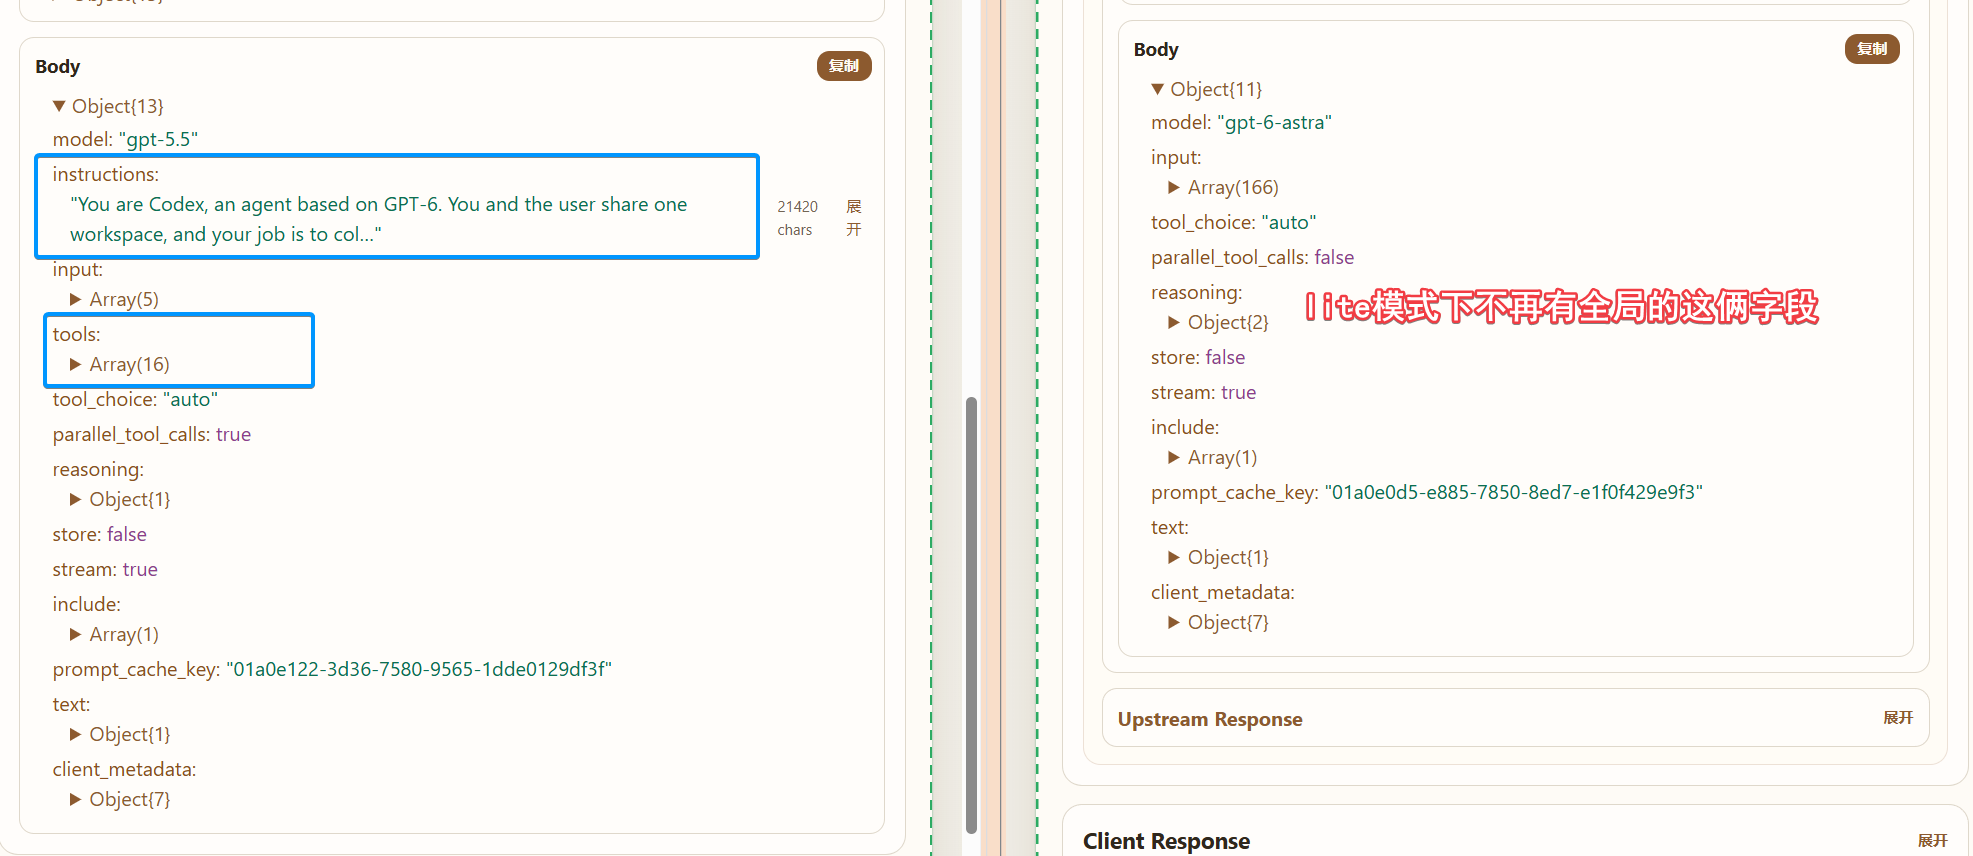
这俩字段移动到了input数组前两个元素:
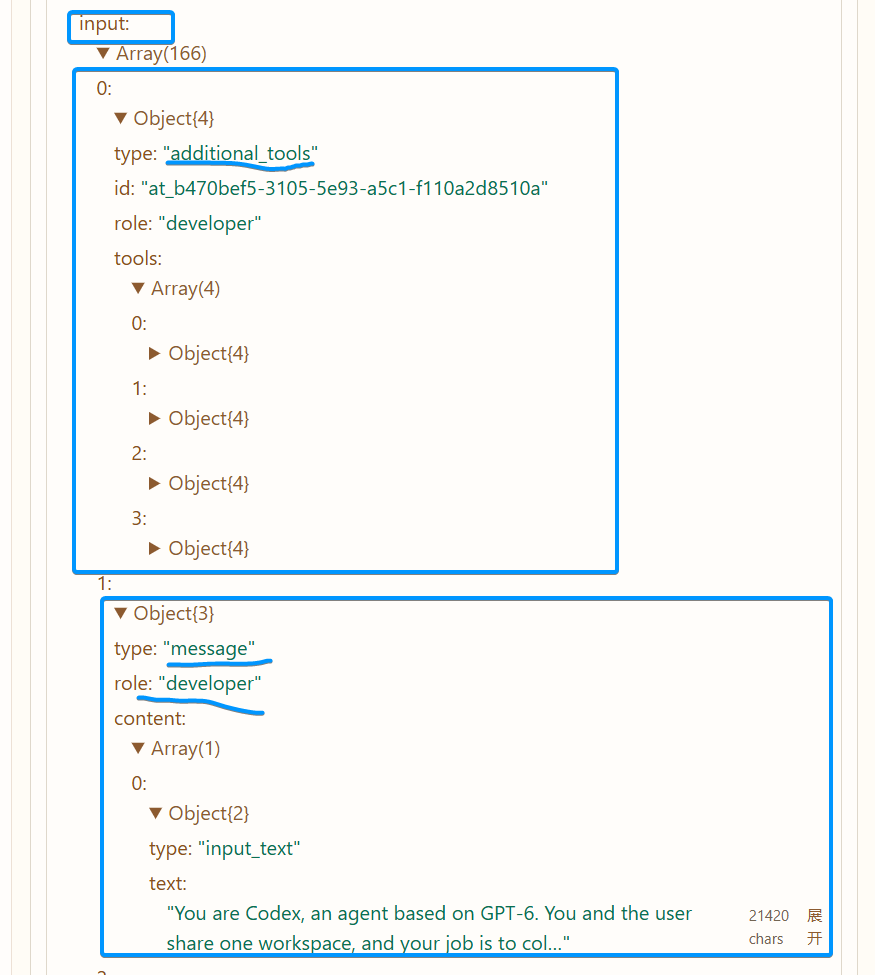
这里可以看出addtional_tools中只有4个工具,而原来是有16个工具的,这就引出第二个要讲的字段tool_mode,因为5.5采用的是direct模式,会把所有工具铺平,而5.6之后都采用了code_mode_only模式,将大量的工具集成到一个js运行时,或者说一个js解释器中,这样就用一个exec工具包住了执行shell、读写文件等等工具。所以工具数量大大减少,只剩4个function tool了。
3 tool_mode
上面已经说了direct就是基础的常见模式,例如执行shell的工具就叫exec_command。而code_mode_only则是一个写js代码的custom工具,参数就是直接写js代码,直接传await toots.exec_command(xxx)来执行shell,这样一个工具包住了所有的工具,并且还支持编排,例如在一个工具调用中串行运行多个工具,理论上可以节省很多交互轮次,进而节省token和耗时。
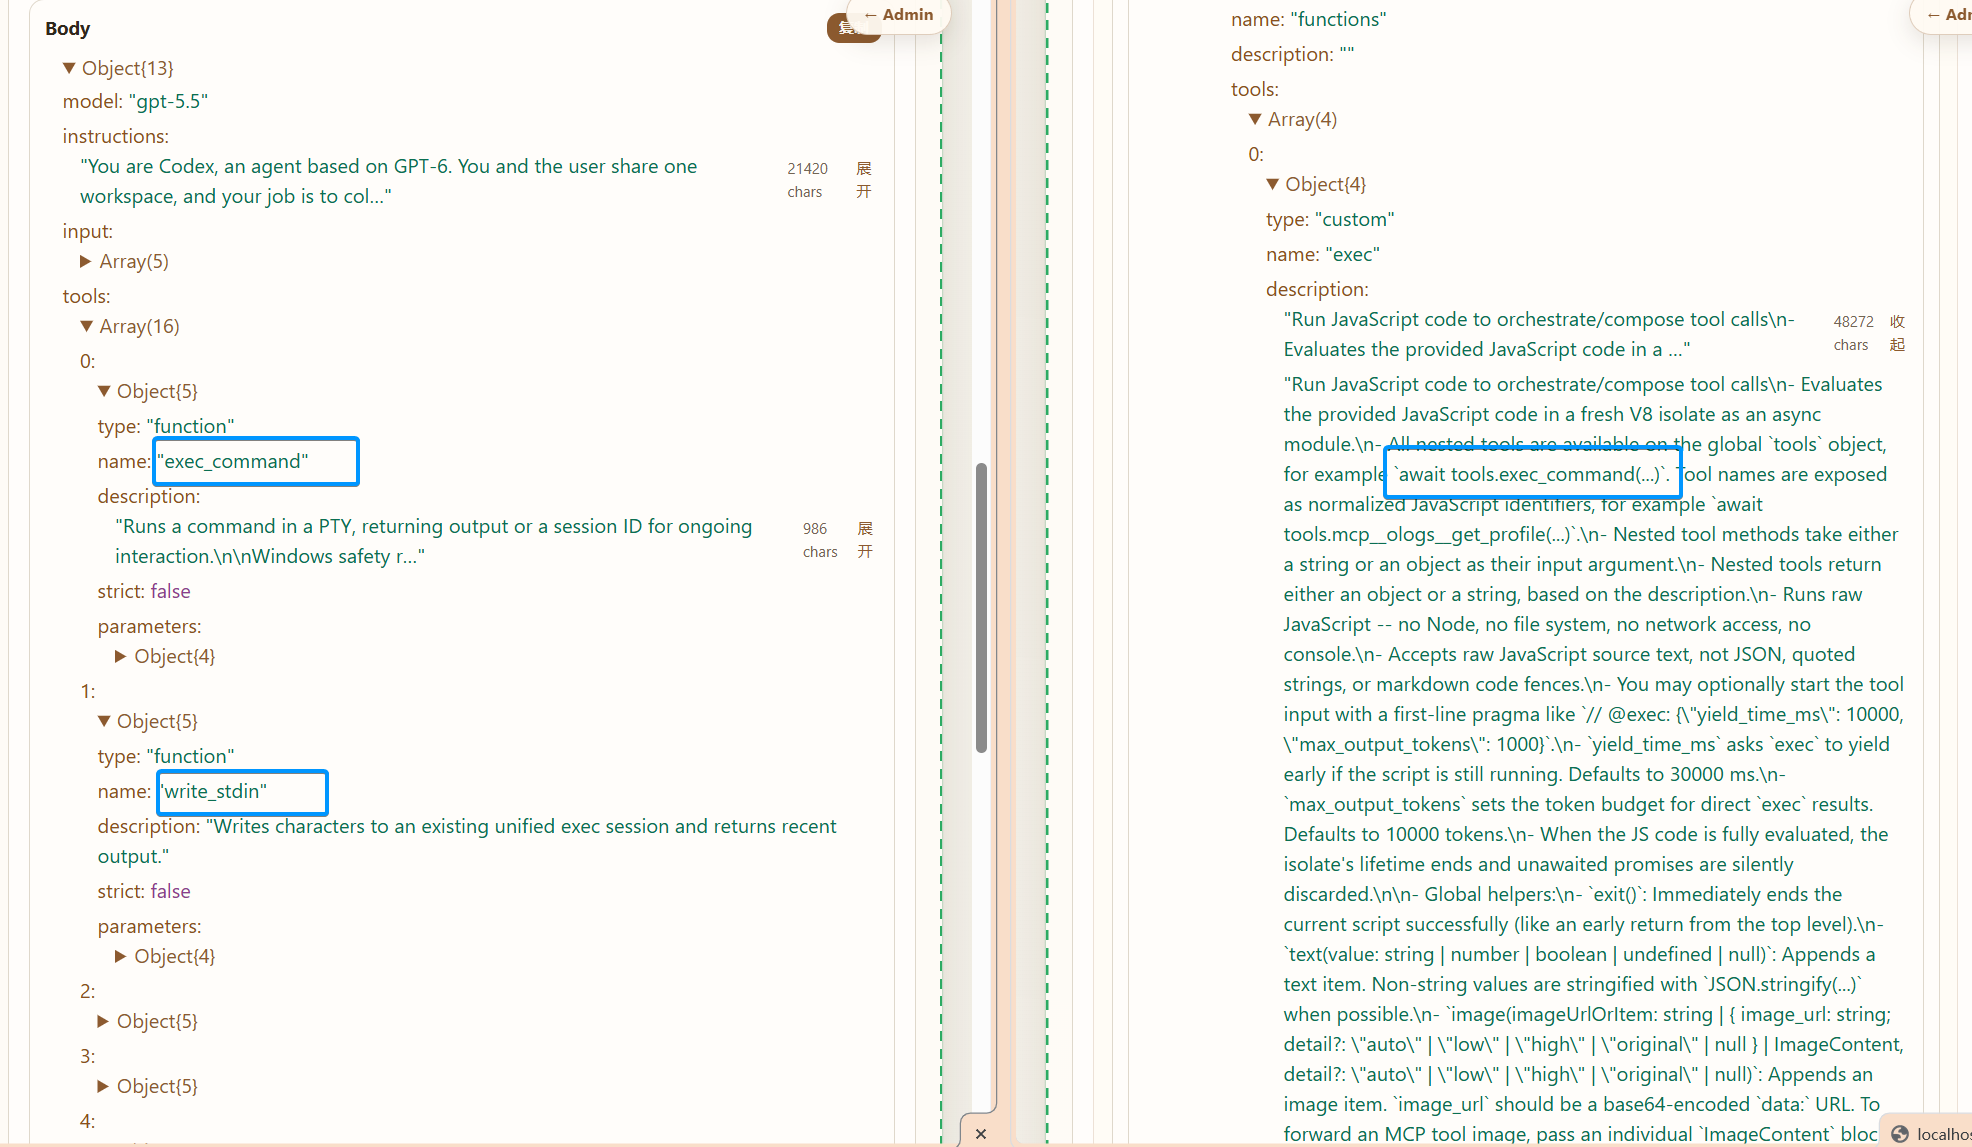
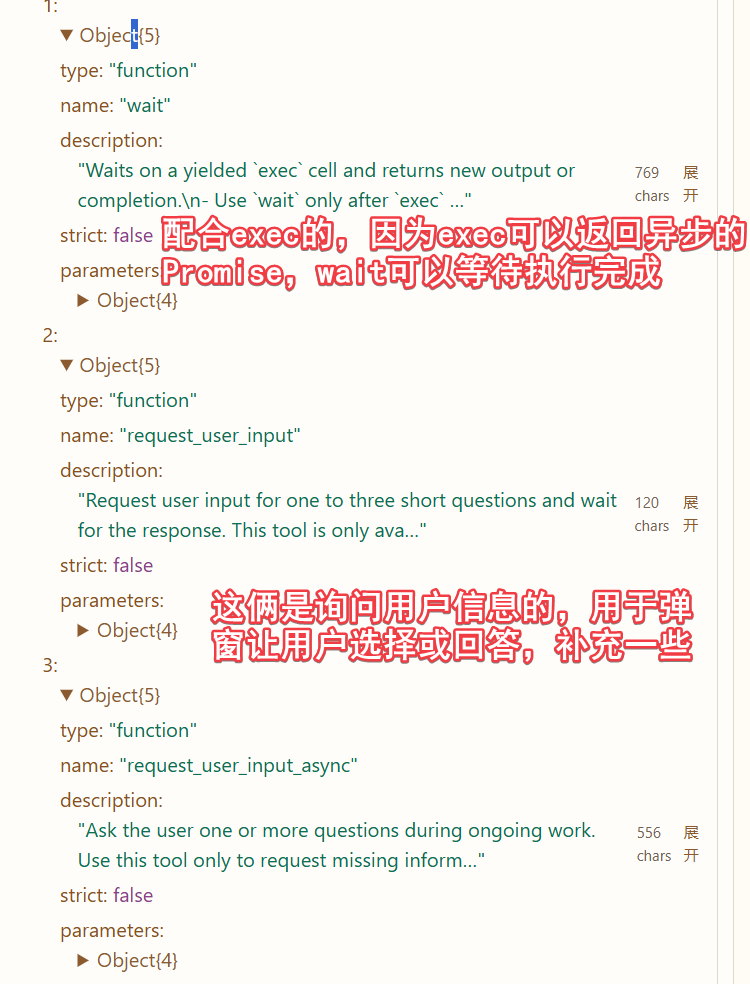
在code_mode_only模式下,parallel_tool_calls参数就写死false,因为js代码中可以自己写并行执行await Promise.all([xxx, xxx]),而不是像direct模式下那样需要多个工具包住多个工具,这样更加简单。在function namespace下,其他三个函数都是辅助类型的,如下:
code_mode_only之前还有个混合的code_mode模式,同时有exec和详细工具列表,目前已经不再使用了,简单一提。
除了function的namespace,默认还有其他的3个namespace:
clock这里面只有一个简单的sleep函数mcp__cua_repl这是一个内置的mcp工具实现computer use,当然你自己增加的mcp工具也会以新namespace的形式追加到tools。collaboration这是多agent或者叫子agent的工具集合,这是v2版本进而引出了multi_agent_version这个配置。
注意exec是个custom类型的工具,有些供应商不见得支持这个类型,如果不支持,就不能用code_mode_only,老老实实用direct模式了。
4 multi_agent_version
none关闭多智能体,v1版本1,v2版本2, null不指定兜底用配置文件中的版本,这个我们不展开详细介绍了,现在绝大多数gpt模型已经升级到v2版本了,v2比v1更鉴权,引入了/A/B/C的id格式,清晰的区分了B智能体是A衍生的,而C又是B创建的,父->子之间可以传消息通信。
不过值得一提的是v2版本虽然更好,但是引入了一个新的父子通信的type=agent_message类型的input参数,有些供应商并不支持这个类型,所以需要进行简单的改造,或者干脆用v1或不用多智能体,给第三方供应商。
5 apply_patch_tool_type
codex使用了一个专门的apply_patch工具进行文件写/更新操作,他有着简洁高效的语法,但是是个custom类型的工具,也就是apply_patch_tool_type配置为freeform的时候,并且tool_mode为direct的时候,会有一个叫apply_patch的工具。
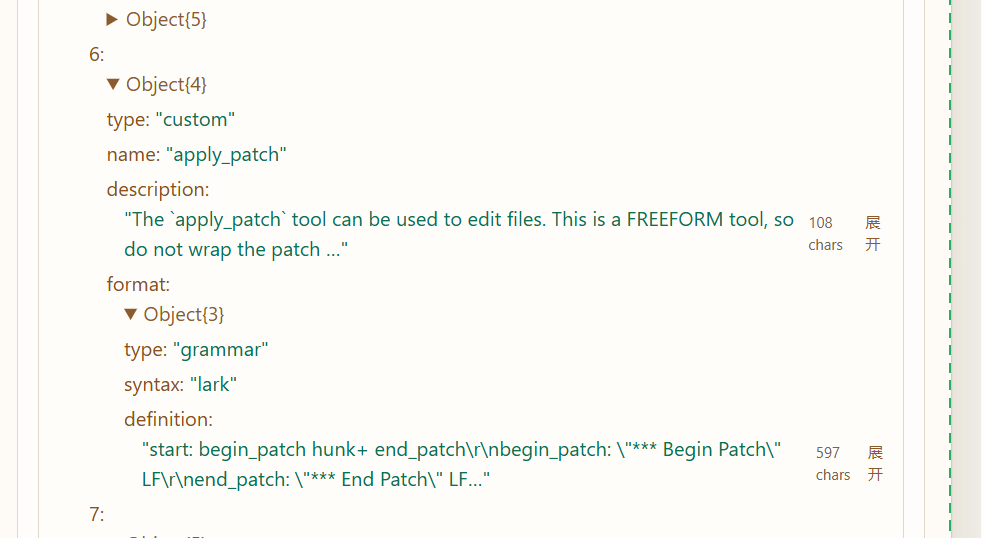
那如果你的供应商不支持custom工具的话,这里需要配置为function或者null,如果tool_mode为direct的时候。function就是类型会变为function,然后有一个入参,这是标准格式,为了那些不支持custom的供应商。
而null则是另一种行为:apply_patch不会作为单独的工具,而是作为exec_command中一个内置的shell指令,实际不会在你的操作系统中,但是会在exec_command中,会在执行阶段被拦截然后codex内部执行,这样你的供应商可以不用支持custom类型的工具,而是通过exec_command这个function类型的工具,就调用了apply_patch写文件。
上面都是direct模式,如果是现在gpt主流的code_mode_only模式,那么就会把apply_patch同样的放到exec中,类似的如果是freeform的时候,exec会有个tools.apply_patch;反之如果是null的话,tools没有这个属性,而是tools.exec_command里可以用这个apply_patch的shell指令。
6 web_search_tool_type
这个参数决定了如果开启了web_search工具的时候,支持的格式是文本还是文本+图片。而真正决定是否注入web_search工具的,则是通过config.toml中的配置项,目前有两种配置.
对于非lite模式,也就是工具在根目录声明的,通过以下配置,可以直接在$.tools中增加web_search工具:
web_search = "live" # 默认是cache,改成disable则是禁止
[tools.web_search]
context_size = "high" # 修改可占用的上下文大小
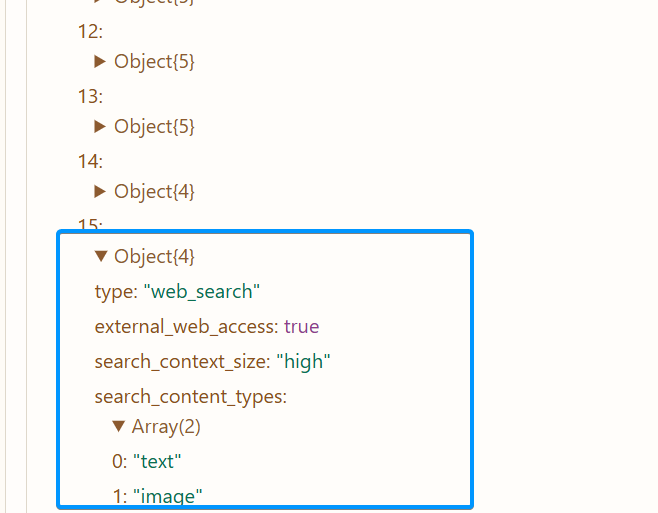
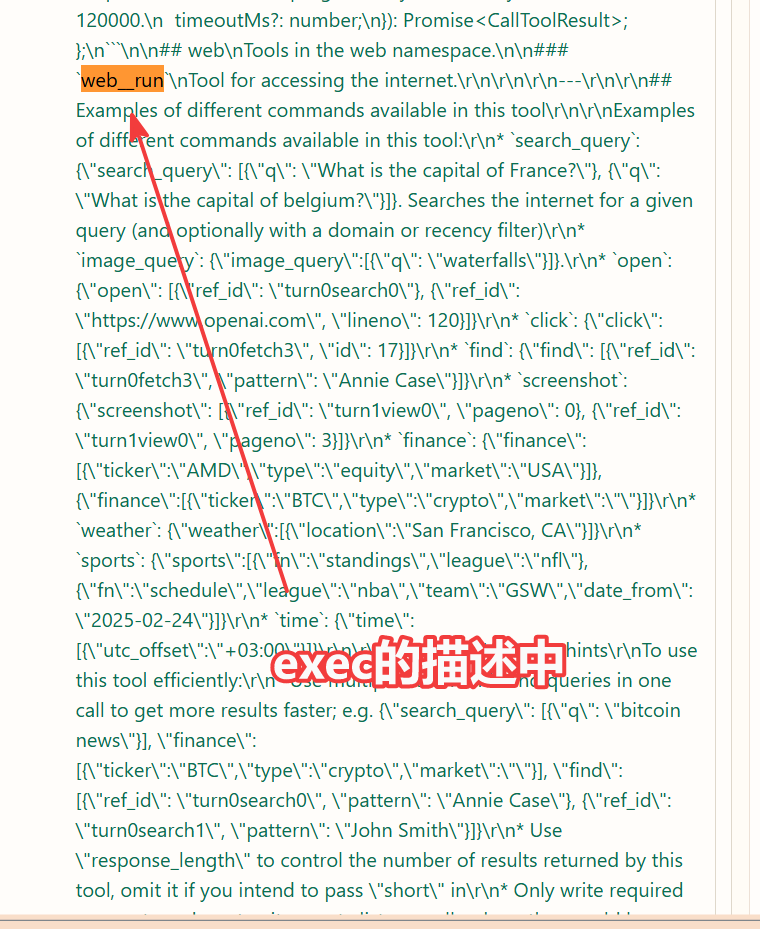
而对于lite模式的话,不再addtional_tools中声明这个web_search工具,而是声明一个web的namespace,工具名则是run,而如果同时又开启了code_mode_only的话,则需要配置为standalone如下:
[model_providers.OpenAI]
# ...
supports_standalone_web_search = true
此时web__run则会内置到exec的tools中,web__run不再是内嵌在原来的请求中完成web搜索,而是单独的endpoint,搞得更复杂了,目前还是alpha阶段,除了openai其他供应商都还不支持。(这个工具触发后,是客户端调用的是专门的POST {base_url}/alpha/search)
7 supports_search_tool
是否支持懒加载 + 搜索合适工具的能力,这个能力本身是为了解决,当引入了太多mcpserver之后,导致工具太多,一方面是openai 默认最多只允许128个工具,另一方面太多的工具会导致上下文巨大,而且会导致大模型选择太多,容易选错。
这个参数设置为true即允许mcp工具将其设置为defer_loading=true,懒加载,然后在请求中会增加一个type=tool_search的工具,官方文档介绍的很详细,大模型判断当前可能会用到一些比如数据库查询的工具,但是目前非懒加载的工具中没有,就会触发这个工具,搜索有没有数据库查询相关的懒加载的工具,搜到之后返回,然后直接进行调用,注意这个搜索->找到->toolCall的过程默认都是在openai服务端进行的。
所以对于用户来说,就是把大量不需要常驻的tool直接设置为defer_loading=true,并带上一个type=tool_search的工具,就好了,剩下的事情都是openai的服务器自己去进行懒加载到模型上下文的函数,哪些需要立即加载进去了。
当然官方文档最后还给出了一种客户端运行搜索查找工具的方式,需要另外的参数,但是一般很少使用,这里不多介绍。
然而,当前supports_search_tool这个设置为true之后,如果针对的是code_mode_only这种更现代的场景,他的作用又有些微妙的变化,甚至可以说他基本没有用了。虽然这个参数开启后,再exec中可以看到,其实有注入到tools中,如下:
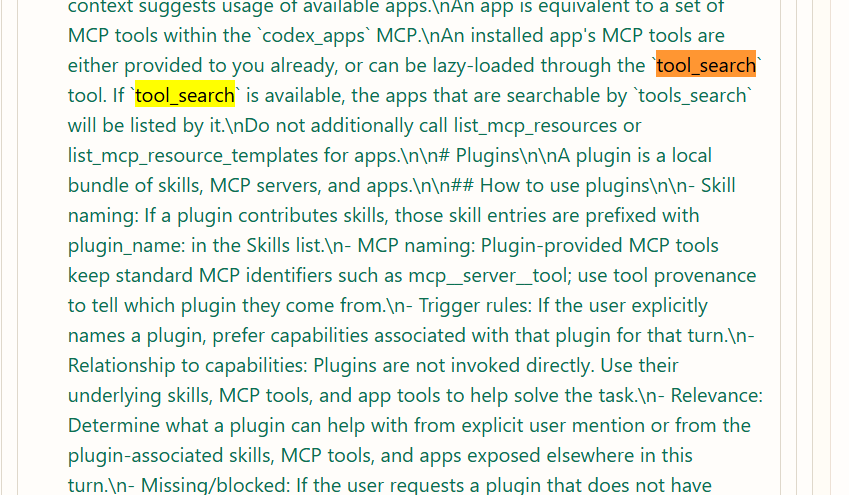
但是实际上,code_mode_only场景下,不太会用懒加载的方式了,因为可以直接注册到tools里面,用户想要用数据库查询工具的话,直接用console.log(ALL_TOOLS.filter(xxx))看下是否有数据库的函数注册了就好了。这也弱化了这个工具的作用。